IA no dia a dia da redação
A plataforma de IA do jornal e o portal onde os jornalistas a usam
Contexto
O Lab de IA da Folha de S.Paulo mantém a plataforma central de IA do jornal. É um serviço em FastAPI com workers Celery que expõe recursos de texto, áudio, imagem, vídeo e RAG para a redação. É multi-provider por design. Um gateway LiteLLM fica na frente dos fornecedores de modelo, a saída estruturada passa por Instructor e PydanticAI, e cada recurso é um plugin. As decisões maiores ficam registradas em ADRs (registros de decisão de arquitetura). Em cima da plataforma fica o portal em que os jornalistas entram, um app SvelteKit com cerca de quinze ferramentas que conversa com a plataforma por um SDK interno tipado. Eu trabalho dos dois lados dessa linha e participo das decisões de design e arquitetura da plataforma.
Meu papel
Sou um dos principais contribuidores dos dois repositórios. Ao longo de mais ou menos um ano entreguei features de ponta a ponta (módulo no backend, API, tela no portal) e ajudei a moldar o design e a arquitetura da plataforma nas discussões de ADR.
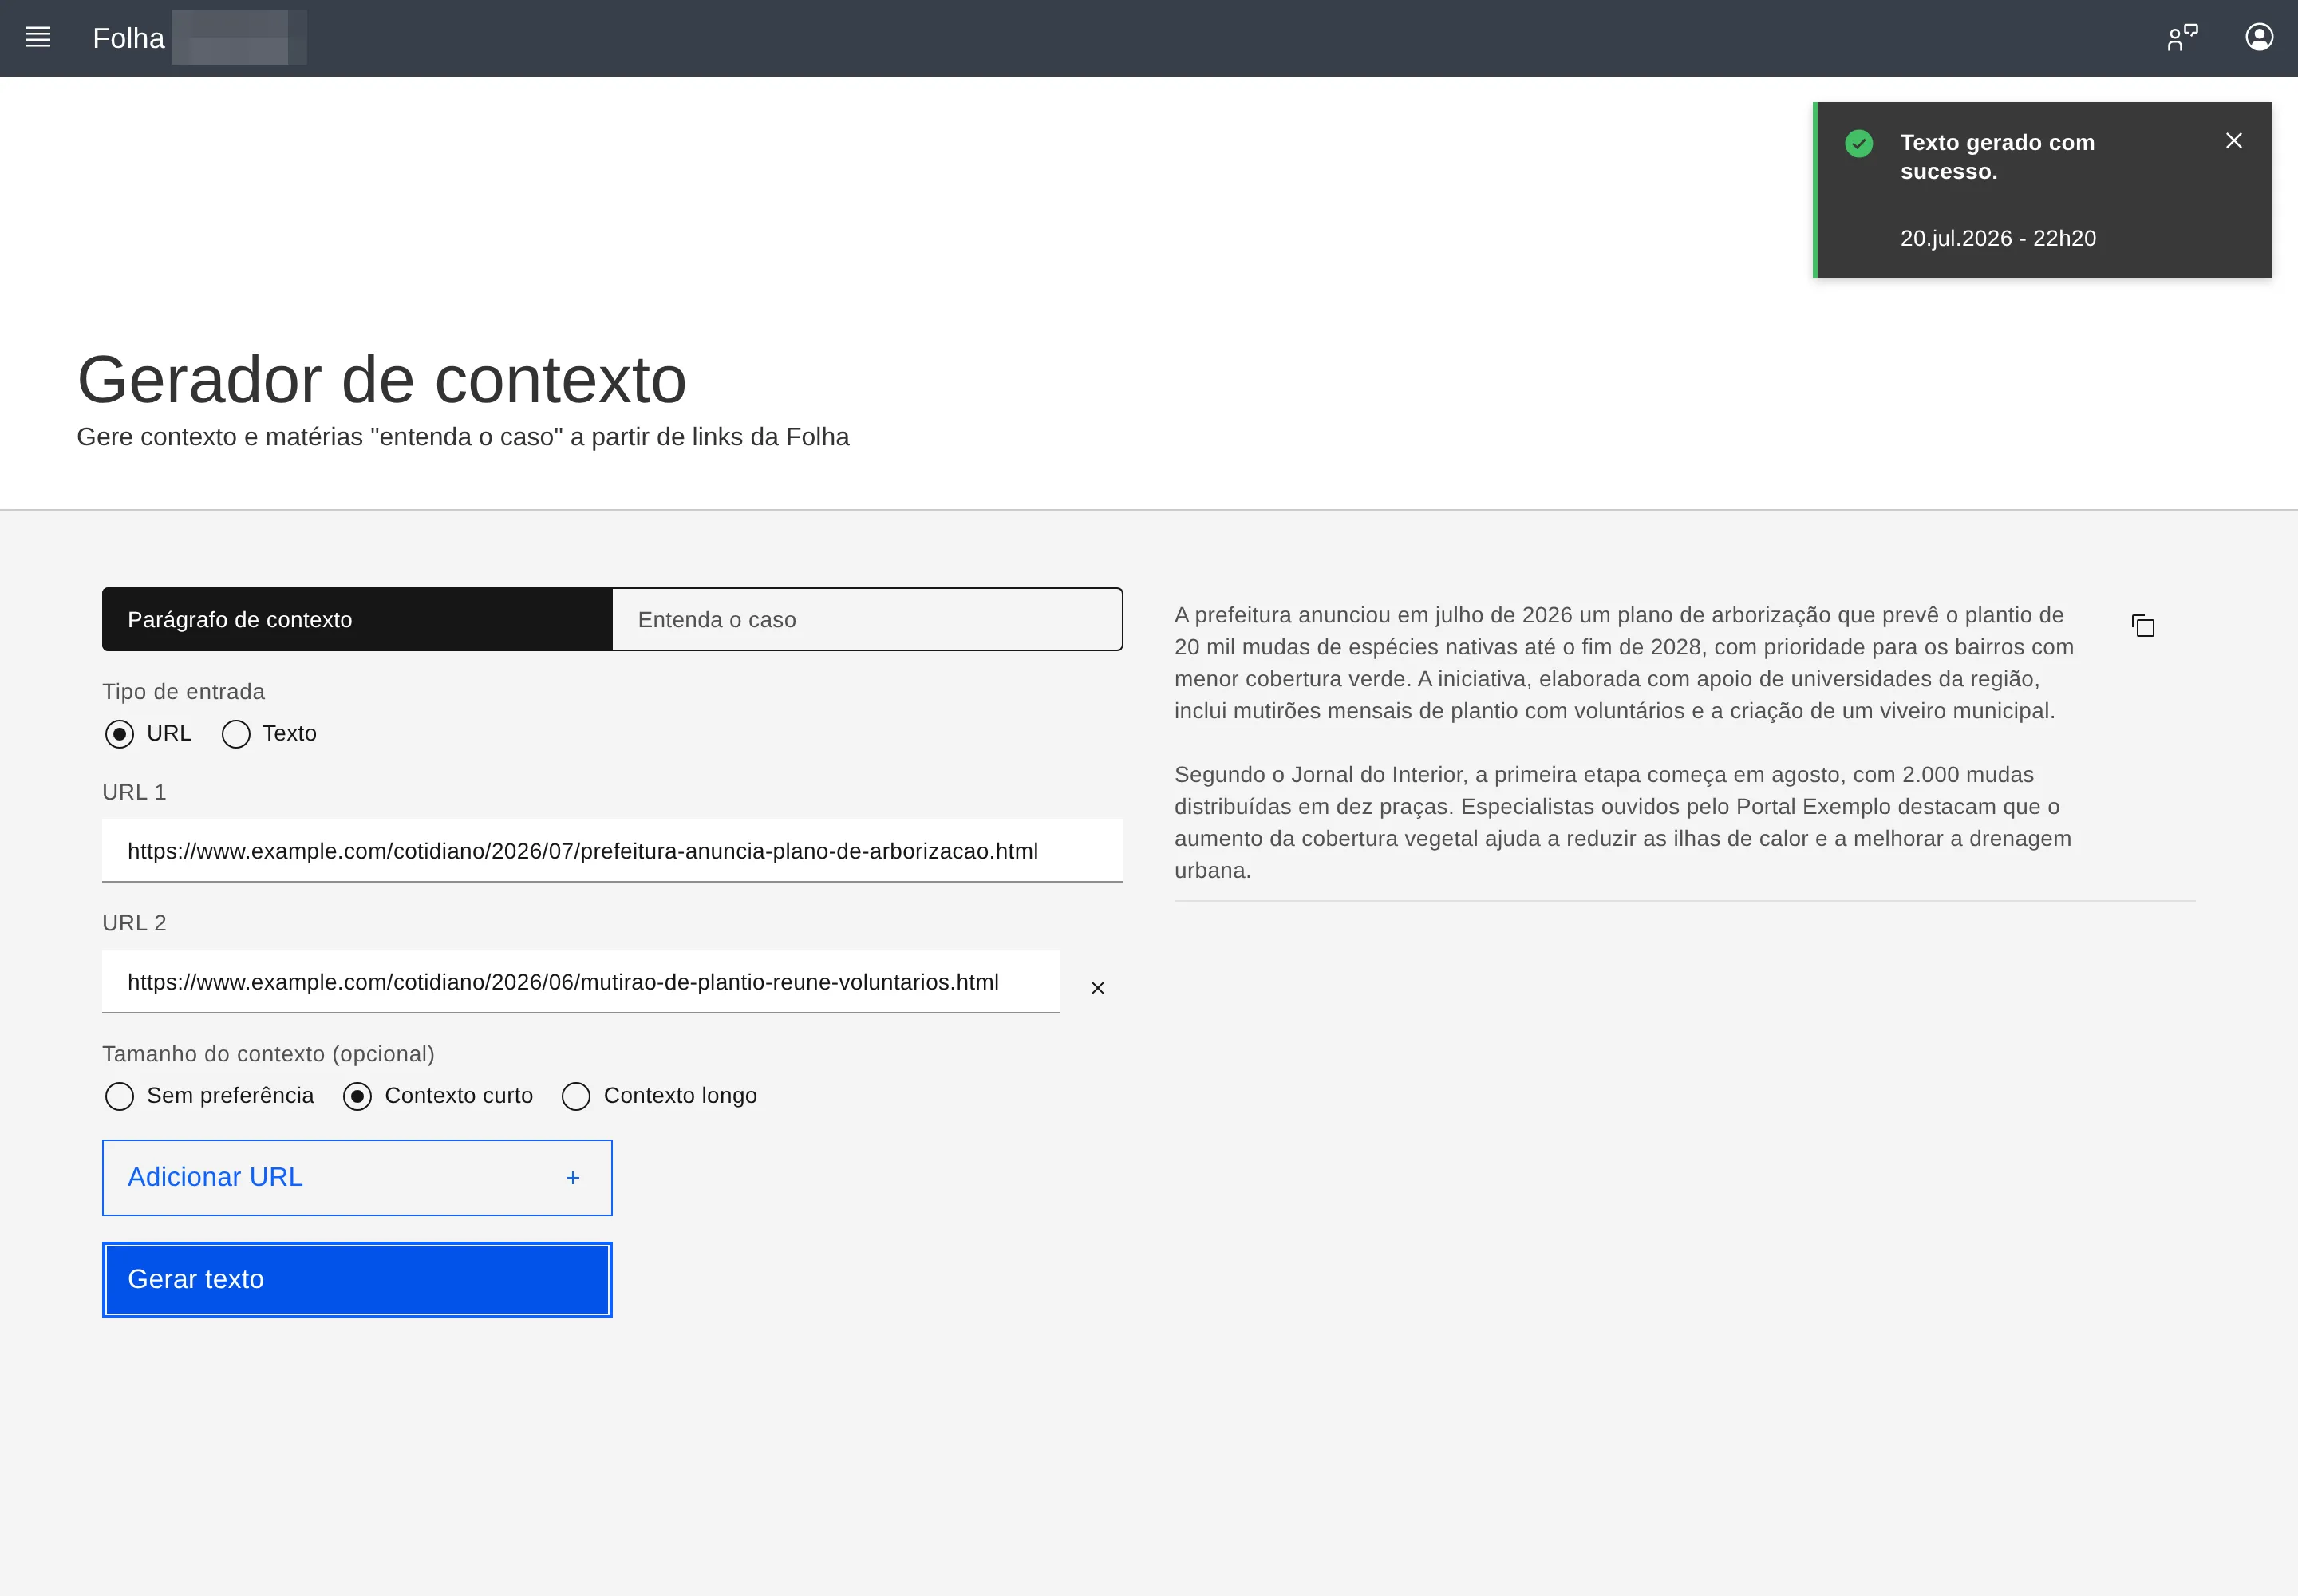
O gerador de contexto é meu de ponta a ponta: serviço, prompts, schemas, API e testes na plataforma, mais a página, a store e os casos de uso no portal. O jornalista cola uma matéria e recebe material de contexto sobre ela.
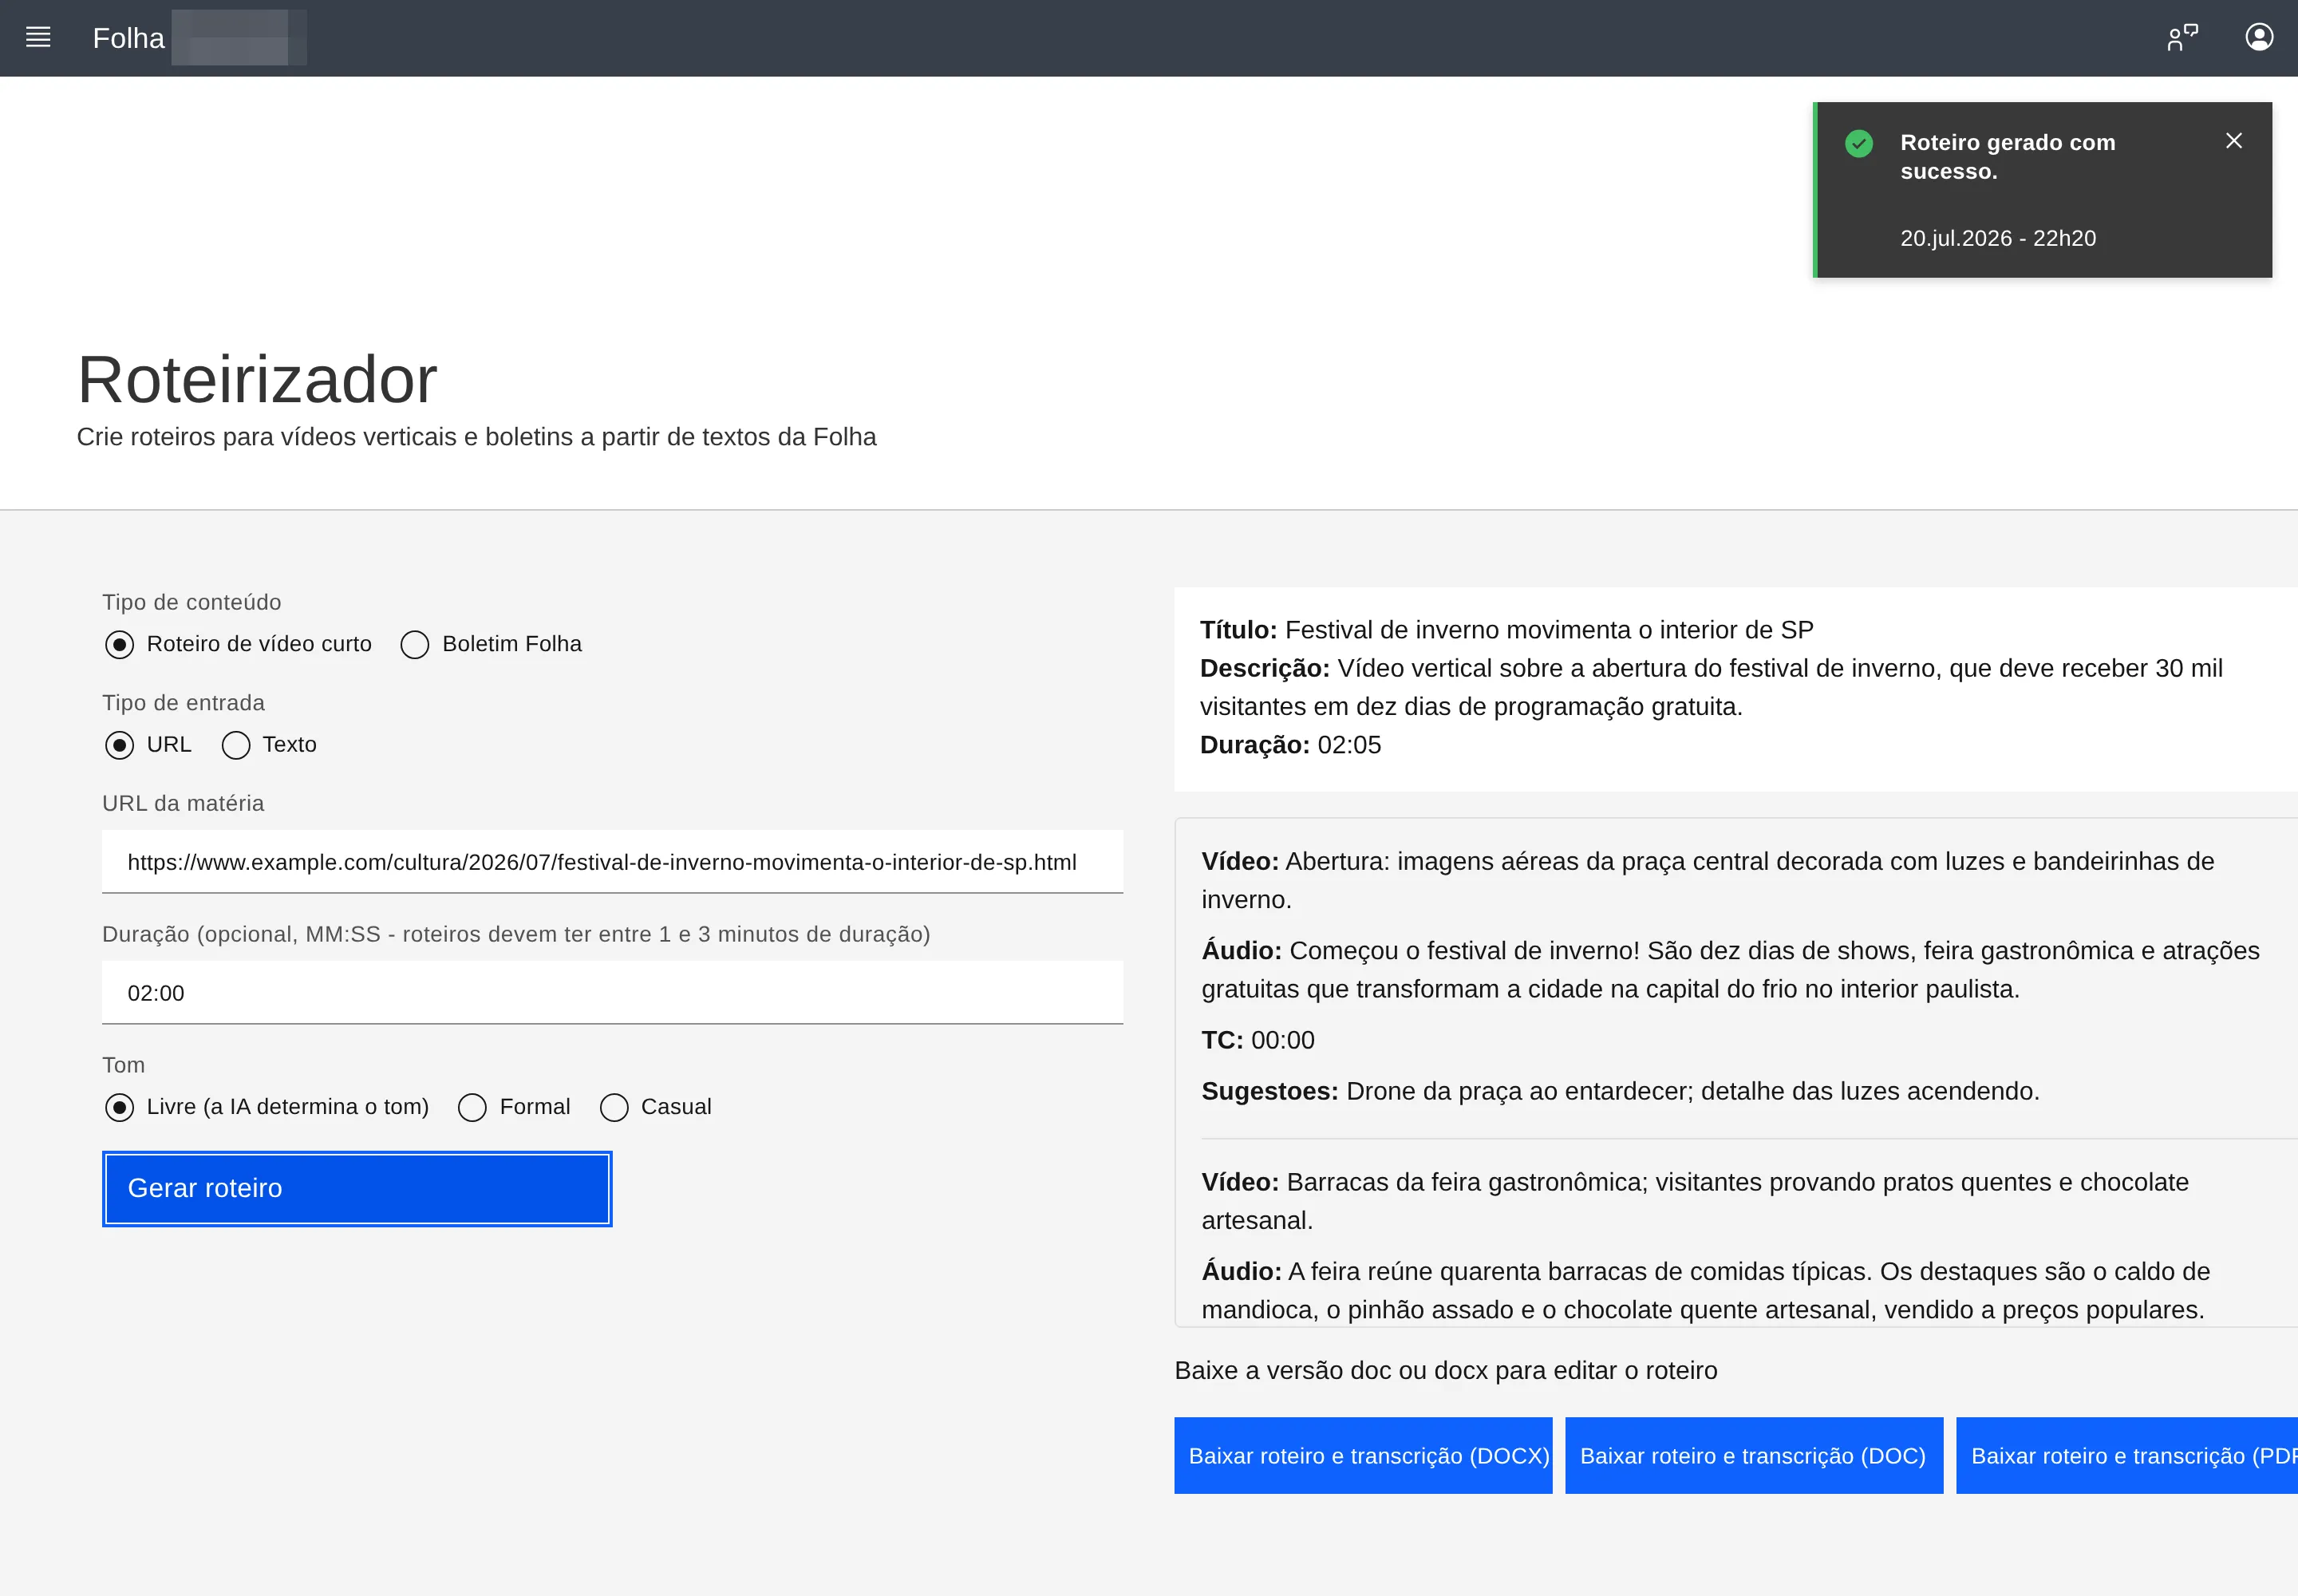
Também fiz do zero o front do roteirizador, a ferramenta do portal que gera roteiro de vídeo. Você passa a URL de uma matéria e ele devolve um roteiro, exportado em DOCX ou PDF. Depois ele ganhou um segundo modo, para os boletins de notícia do jornal; o lado de roteirização desse modo no backend também foi meu, com uma API de discriminated union para os dois modos dividirem o mesmo endpoint, cada um com seu schema de resposta.
Coisas menores ao longo do ano: o seletor de vozes para a geração de vídeo com IA, créditos de vídeo editáveis, tratamento de URLs nas ferramentas de RAG e várias migrações para novas versões desse SDK interno no front. Fora muita iteração de prompt e schema, puxada pelo que a redação e o time de TV diziam que estava errado.
- Gerador de contexto página, store e casos de uso
- Roteirizador front feito do zero; DOCX e PDF gerados no navegador
- Modo boletim o segundo modo do roteirizador
- Seletor de vozes TTS, créditos editáveis geração de vídeo com IA
- as outras ferramentas
- API do gerador de contexto serviço, prompts, schemas, testes
- Modo de roteirização do boletim um endpoint, API em discriminated union
- Event loop persistente nas tasks assíncronas do Celery correção em produção, aplicada em todos os módulos de task assíncrona
- tratamento de URLs no RAG
- os outros recursos
= meu trabalho
A parte difícil
A história que eu ainda conto é a de um bug de event loop. Task de Celery é síncrona, o código da plataforma é assíncrono, e a solução ingênua (abrir um event loop novo a cada task) quebra, sem avisar, qualquer cliente que segura conexão entre chamadas. Apareceu em produção. A minha correção foi um event loop persistente reaproveitado pelo worker, aplicada em todos os módulos de task assíncrona da plataforma.
A exportação em DOCX e PDF foi a outra. Jornalista precisa do arquivo pronto, e eu não queria passar pelo servidor para isso. Os documentos são gerados inteiros no navegador. Isso significa montar títulos, tabelas e blocos de fala na mão em JavaScript e fazer os dois formatos saírem parecidos.
Toda feature aqui também passa por dois repositórios, três linguagens (Python, TypeScript, Svelte) e duas culturas de review. A feature não acaba quando o endpoint responde. Acaba quando funciona nos dois repositórios.
Resultado
Os dois sistemas estão em uso diário na redação e os dois continuam recebendo feature nova. As ferramentas que eu fiz estão em uso e ainda recebo feedback sobre elas. Foi mexendo nelas que passei a maior parte do ano.
Projeto interno da Folha de S.Paulo (descrito aqui sem código, dados editoriais ou detalhes de infraestrutura).