CHASE
Monitoramento de notícias com IA
Monitoramento de notícias com IA e detecção de tendências para a redação, mais um chat baseado no que ele coleta
Contexto
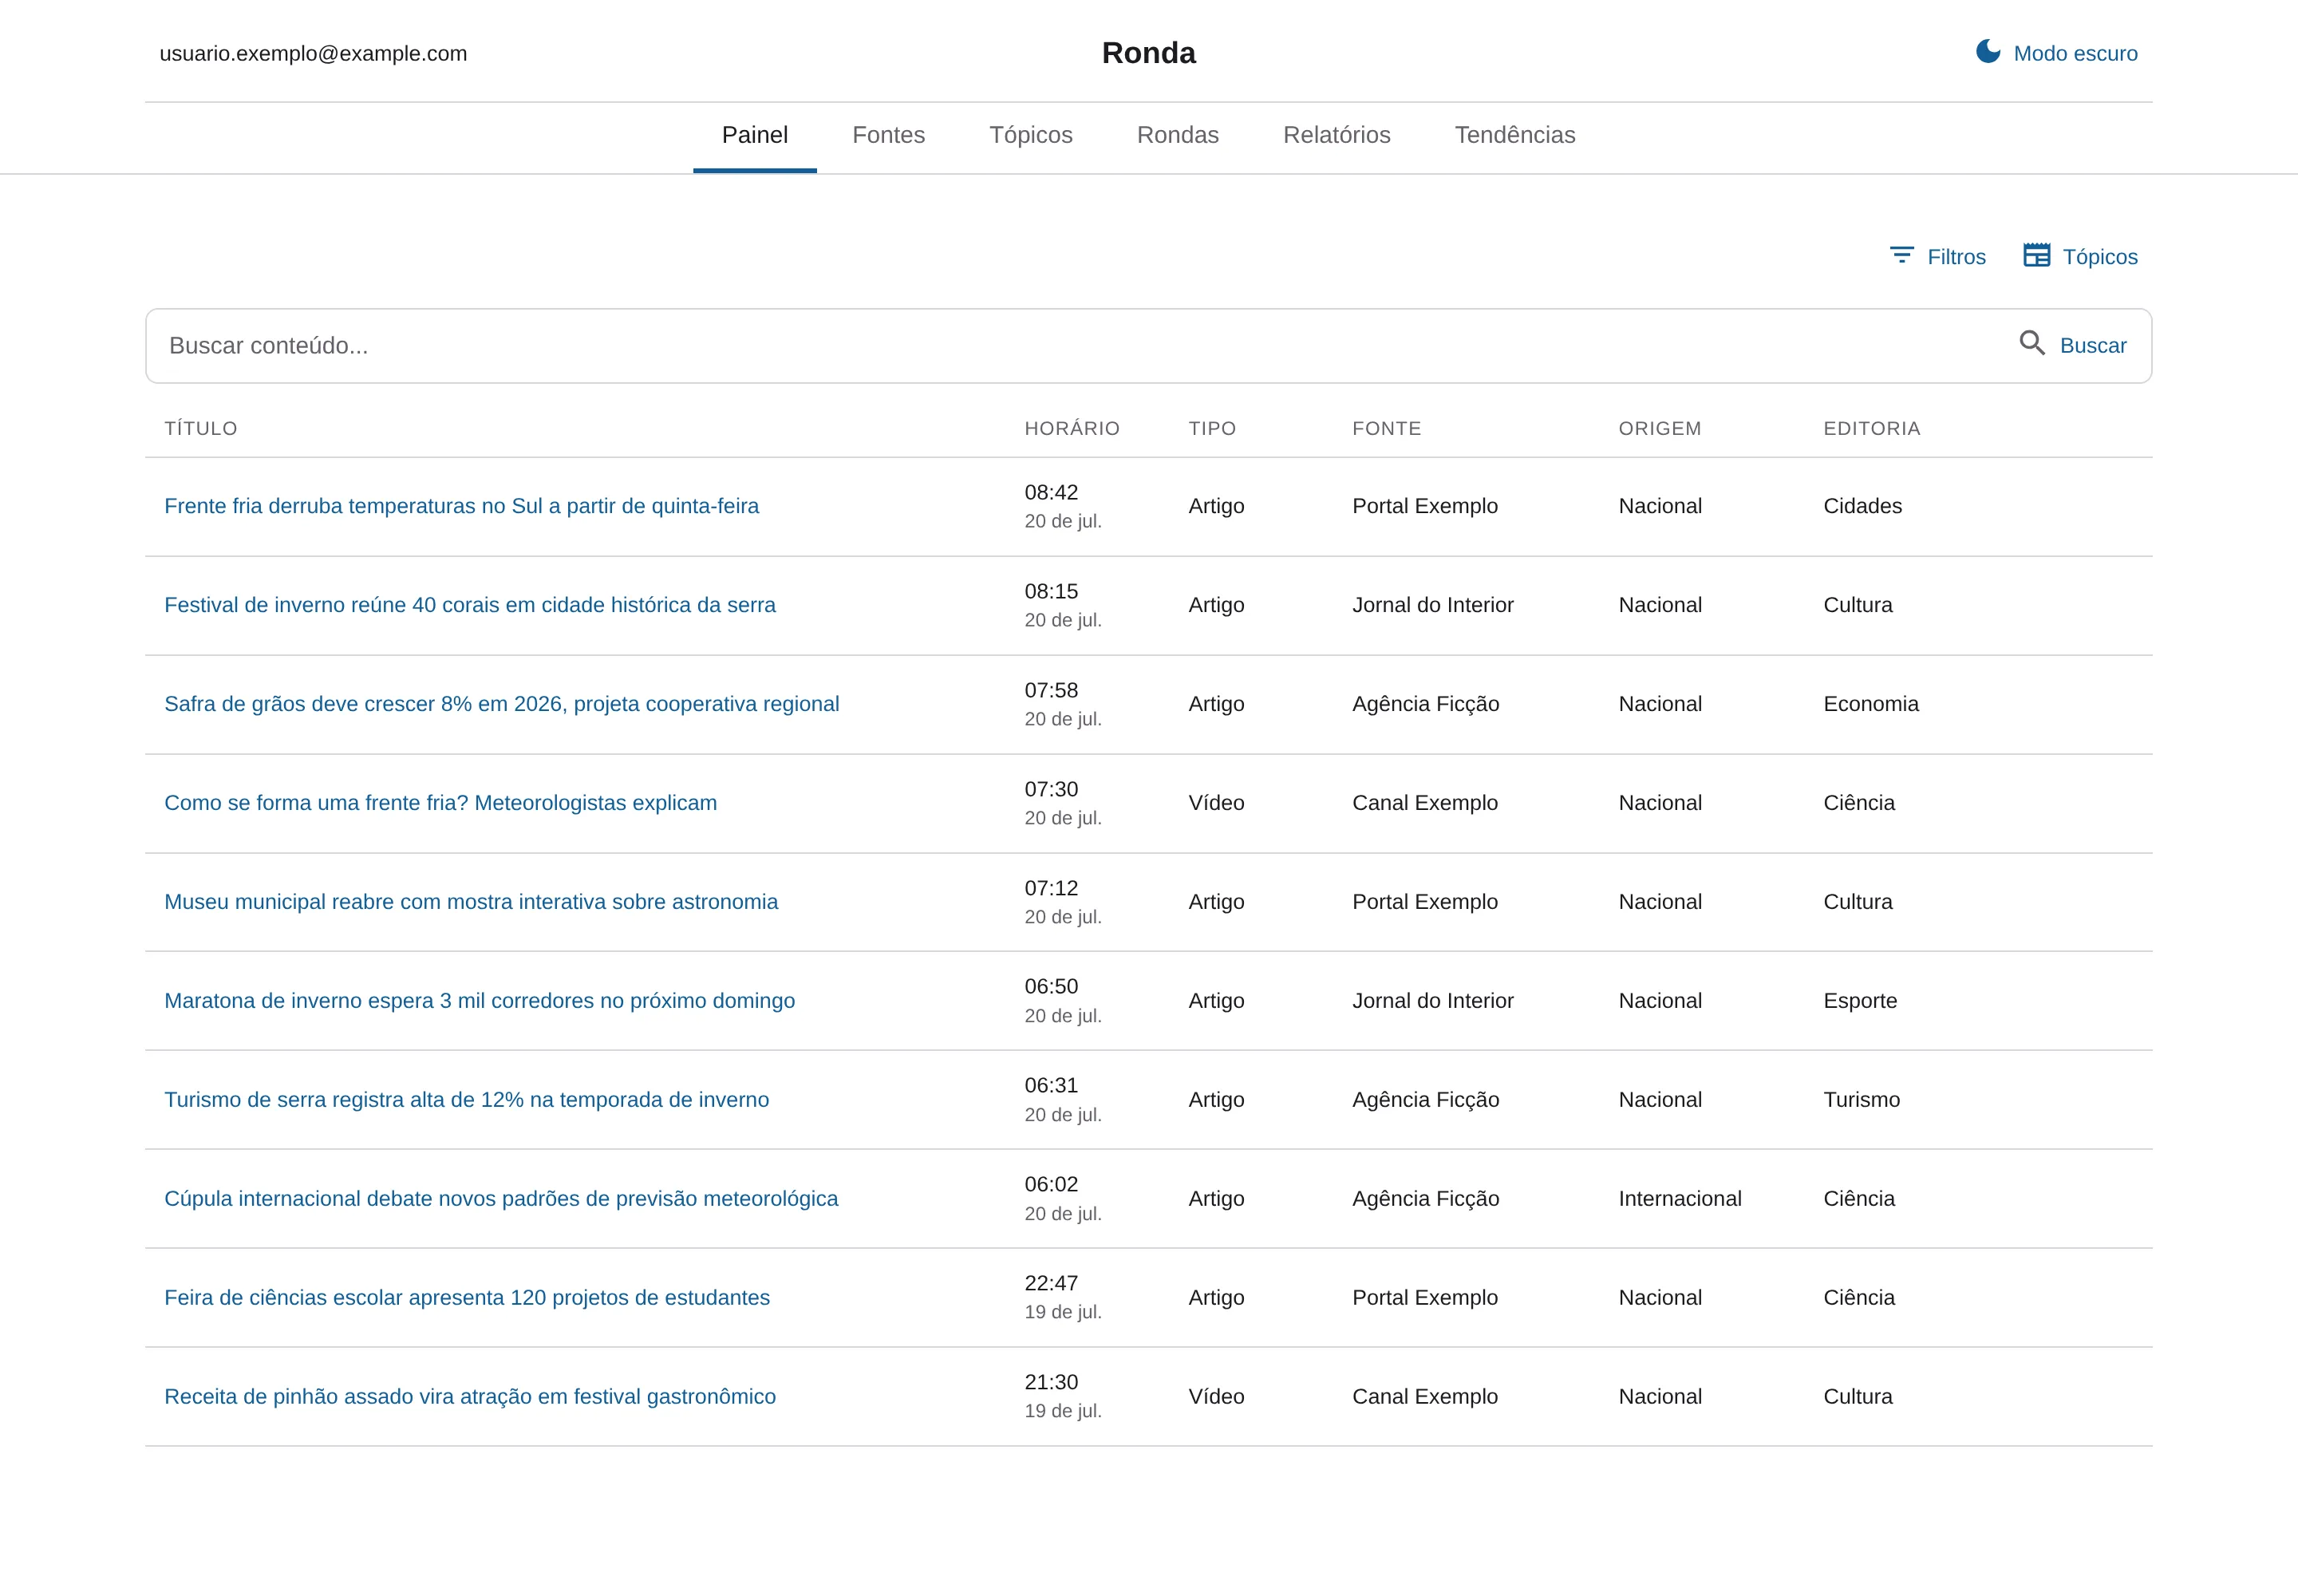
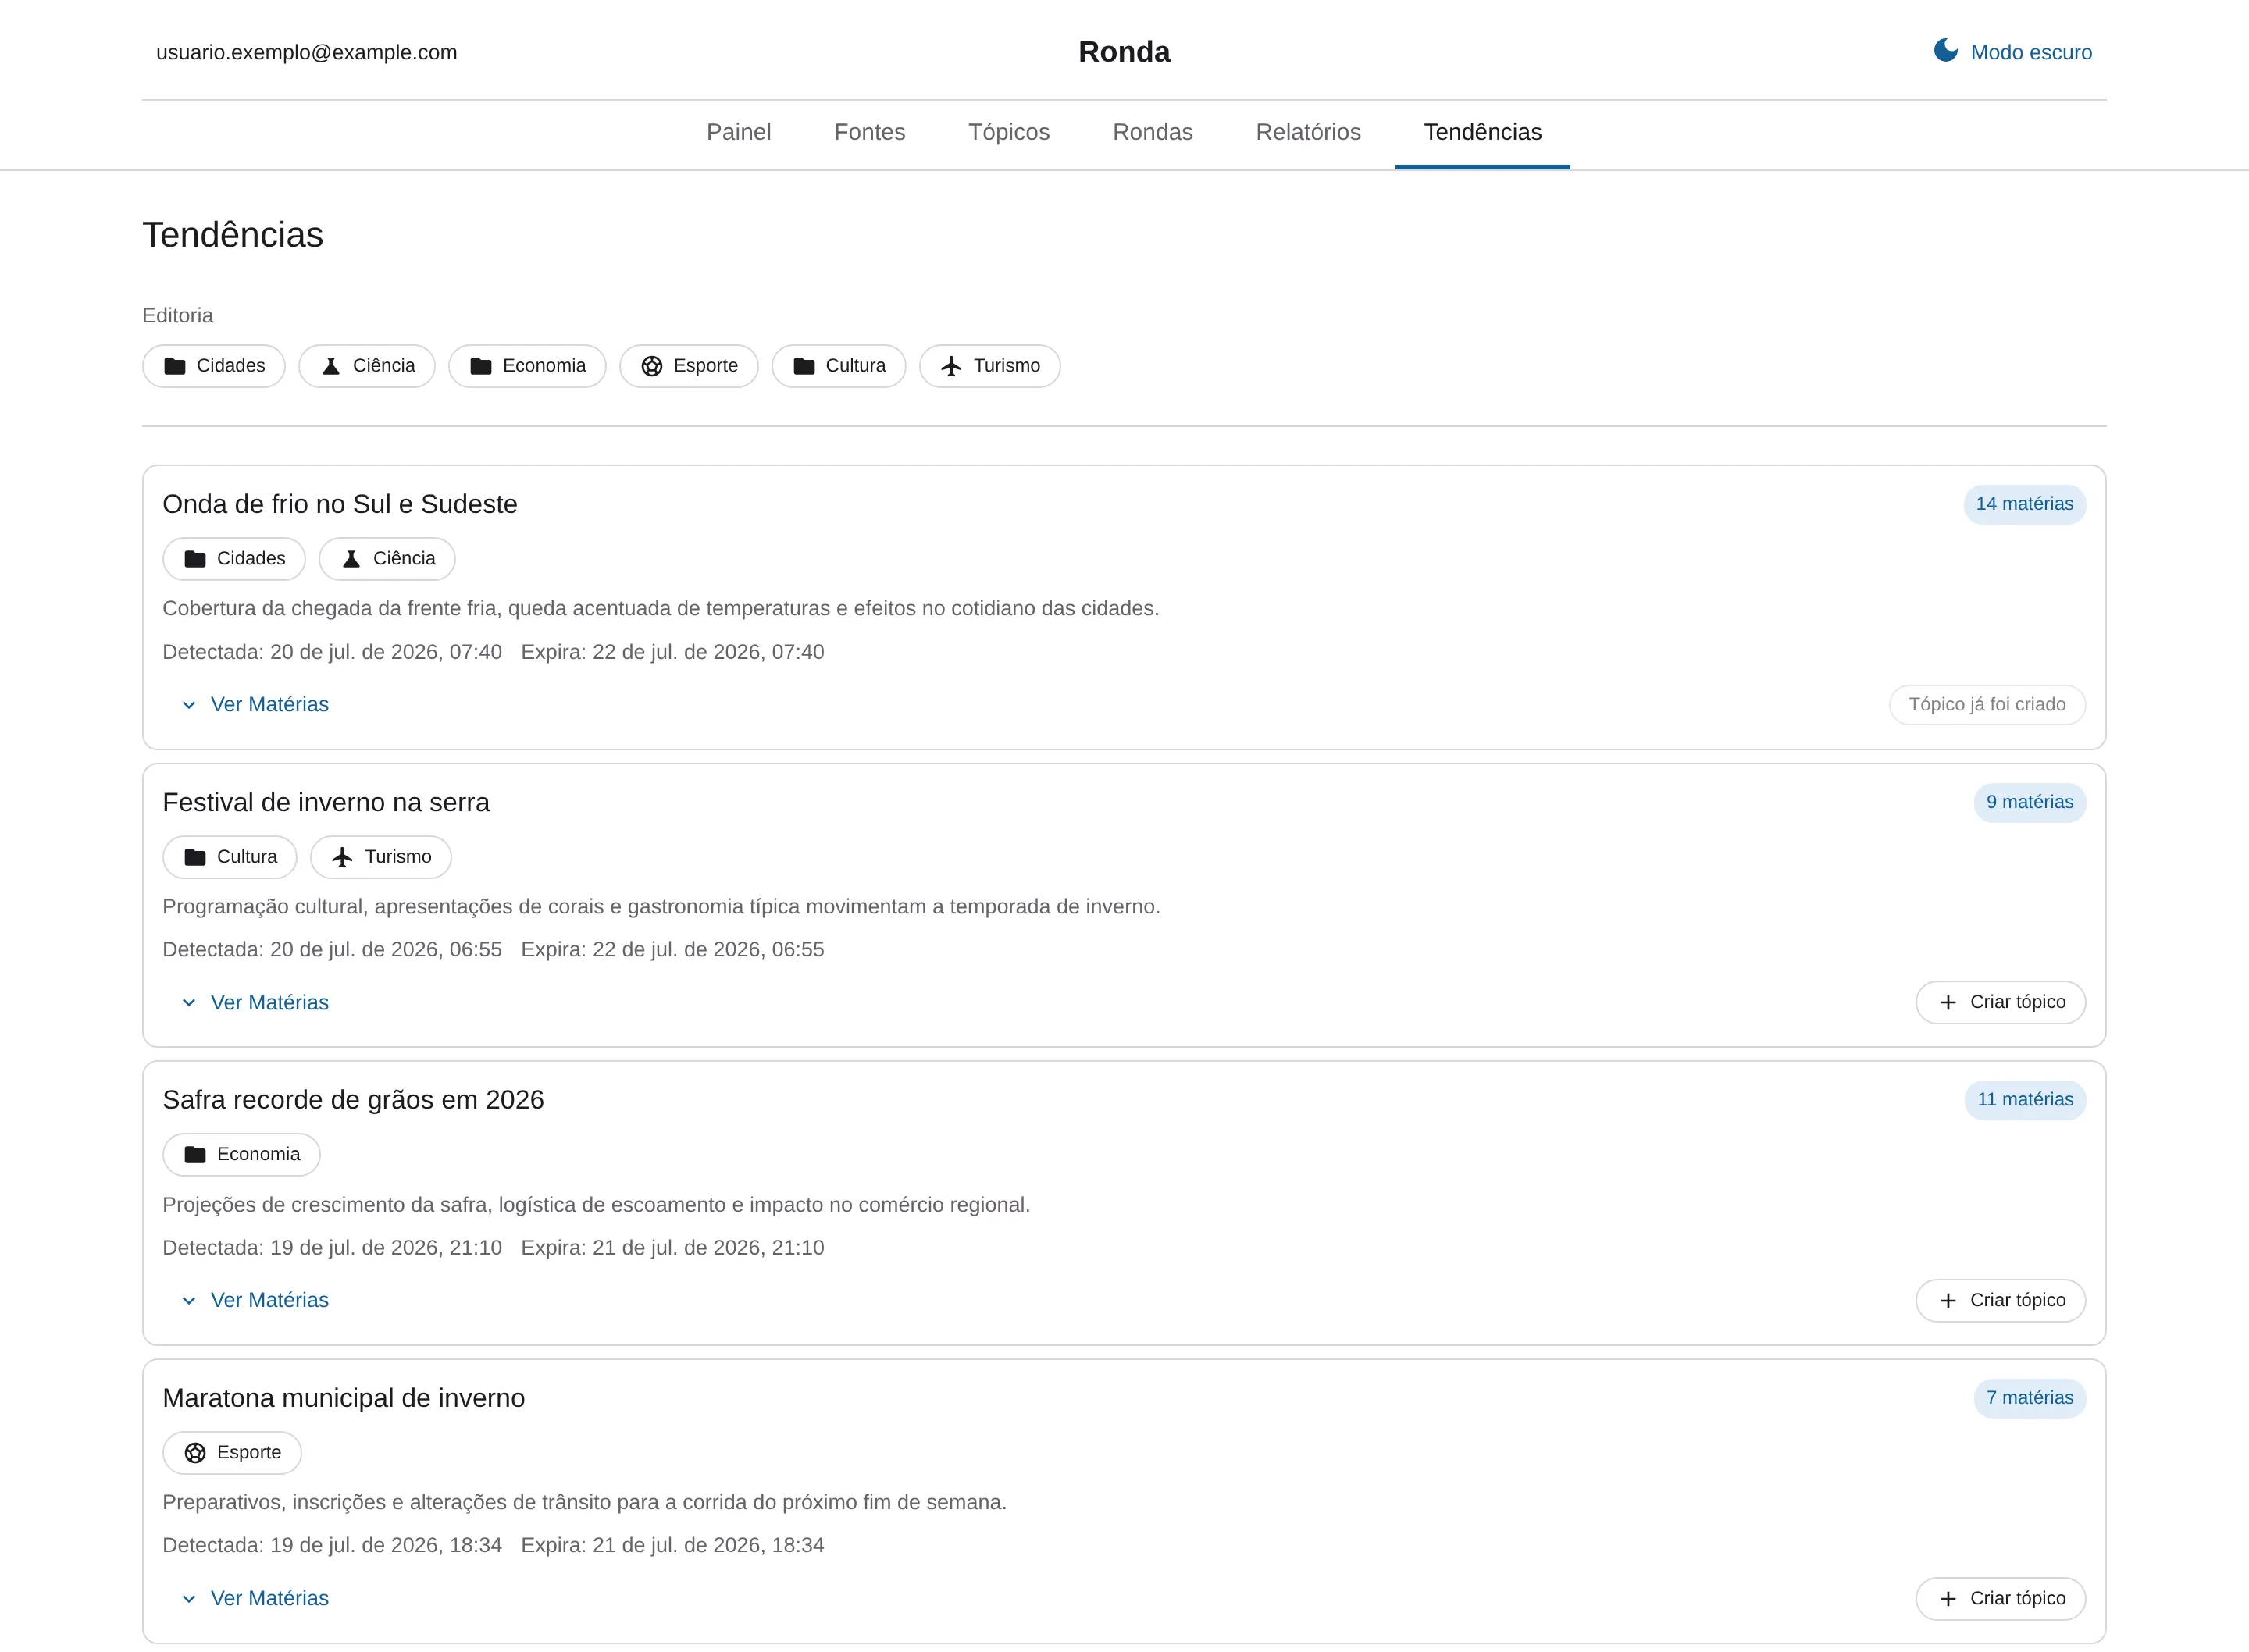
A redação da Folha de S.Paulo acompanhava a concorrência e as redes sociais na mão. O Chase, o sistema de monitoramento de notícias do lab, faz isso sozinho, em rondas programadas. Ele puxa feeds RSS, páginas via scraping, canais do YouTube, perfis do Instagram e APIs JSON. Duplicata cai fora. O que sobra recebe resumo por LLM, classificação por editoria e embedding, e é casado com os tópicos seguidos. Os editores controlam tudo por um painel em Vue 3, recebem os avisos no Discord ou por e-mail e podem fazer perguntas num chat.
Meu papel
Projetei e implementei a arquitetura atual do Chase. Ele começou num formato bem mais simples. Entre março e setembro de 2026 eu o transformei no pipeline de quatro etapas desta página e construí a maior parte do que roda em cima dele. Está em uso diário desde então.
O lado do usuário é meu de ponta a ponta: login SSO e, depois, níveis de permissão, tópicos e rondas com dono, follows, pins e notificações pessoais. As rondas também, em torno das quais a redação se organiza. O editor agrupa tópicos e fontes numa ronda e recebe relatórios agendados, em PDF ou planilha, no Discord e por e-mail. Adicionei YouTube (com transcrição, e Whisper quando o vídeo não tem legenda), Instagram e APIs JSON como conectores. O monitoramento de YouTube nasceu de um pipeline avulso com Whisper e Claude que eu tinha feito antes de o Chase existir.
A peça mais nova é o chat, entregue em outubro de 2026. O editor escolhe um escopo (um tópico, uma ronda, algumas fontes ou tudo) e faz perguntas em português. O modelo responde só com o conteúdo monitorado: precisa chamar ferramentas para buscar trechos e contar menções antes de responder, cada afirmação traz uma citação numerada, e a citação guarda o título e a URL do item porque a retenção vai apagar o item em si. Chamadas de ferramenta e itens abertos têm teto por pergunta, conversas e perguntas por dia têm teto por usuário, e falha do modelo devolve erro sem gravar nada.
- Login SSO
- Rondas tópicos e fontes agrupados, relatórios agendados
- Follows, pins e níveis de permissão
- Chat perguntas respondidas só com o conteúdo monitorado, com citações
- Tópicos o que os editores seguem, casado por embedding
- Relatórios briefings por tópico, ronda ou digest
- Fontes, tendências
- 01 Fontes um conector por tipo, cada um com o próprio agendamento
- Feeds RSS
- Páginas da web Playwright, extração assistida por LLM
- YouTube transcrições, com Whisper quando o vídeo não tem legenda
- APIs JSON
- 02 Base de matérias PostgreSQL + pgvector
- deduplicada pela URL normalizada
- guardada pela janela de retenção
- 03 Enriquecimento com LLM um workflow filho por matéria
- resumo em português
- classificação por editoria
- embedding
- casamento com os tópicos seguidos
- 04 Detecção de tendências a cada dez minutos
- DBSCAN nas últimas 24 horas
- clusters fundidos às tendências ativas
- nome dado por um LLM
- 05 Aviso e limpeza
- Alertas Discord, e-mail
- Relatórios PDF, XLSX, e-mail, agendados
- Limpeza de hora em hora: conteúdo vencido, sessões, fontes mortas, relatórios travados
= meu trabalho
A parte difícil
Durabilidade. O pipeline tem quatro etapas (ingestão, enriquecimento, detecção de tendências e notificação), e em cron puro isso quebra o tempo todo. Um feed dá timeout, uma chamada de LLM toma rate limit, o job morre no meio e quem avisa é o editor. Esse era o centro da reformulação: reconstruí as etapas como workflows e schedules no Temporal, que transforma retry e falha parcial em problema do framework, e não em código defensivo em cada serviço. A ronda de um editor é um schedule.
Depois, a detecção de tendências. Cada matéria vira um embedding (uma representação numérica do significado) guardado no pgvector. A cada dez minutos um job clusteriza as últimas 24 horas com DBSCAN, um algoritmo que não precisa saber de antemão quantos grupos existem, e um LLM dá nome em português a cada cluster. Ninguém sabe quantos assuntos estão rodando num dado momento, e a matéria que não pertence a cluster nenhum vira ruído.
Depois, manter a coisa viva. Com a redação usando todo dia, os bugs passaram a ser de operação: chamada de LLM que nunca voltava e segurava um slot do worker, conexão com o banco semiaberta fazendo o mesmo, enriquecimento disparando duas vezes para a mesma matéria, schedules de polling acordando todos juntos depois de um deploy. Cada correção é pequena (timeout em toda chamada de modelo, statements com limite no banco, concorrência do worker presa ao tamanho do pool, jitter nos schedules). Juntas, separam uma demo de um sistema. Um workflow de limpeza de hora em hora apaga conteúdo vencido, sessões expiradas, fontes mortas e relatórios travados.
Por último, a suíte de testes: testes unitários herméticos, com dublês para a sessão, o Temporal e o LLM, e testes de integração que rodam as migrations reais contra o Postgres e um dev server do Temporal em containers.
Resultado
Em uso diário na redação, onde substituiu o monitoramento manual: o editor monta as próprias rondas, os relatórios chegam no Discord e por e-mail, e o chat responde ao que o relatório não responde.
Projeto interno da Folha de S.Paulo (descrito aqui sem código, dados editoriais ou detalhes de infraestrutura).